파이썬 Celery·Redis 완벽 가이드: 비동기 작업 큐와 분산 처리
Celery와 Redis로 파이썬 백그라운드 작업 큐를 구성하고 재시도·중복 실행·운영 장애까지 안전하게 다루는 방법을 설명합니다.
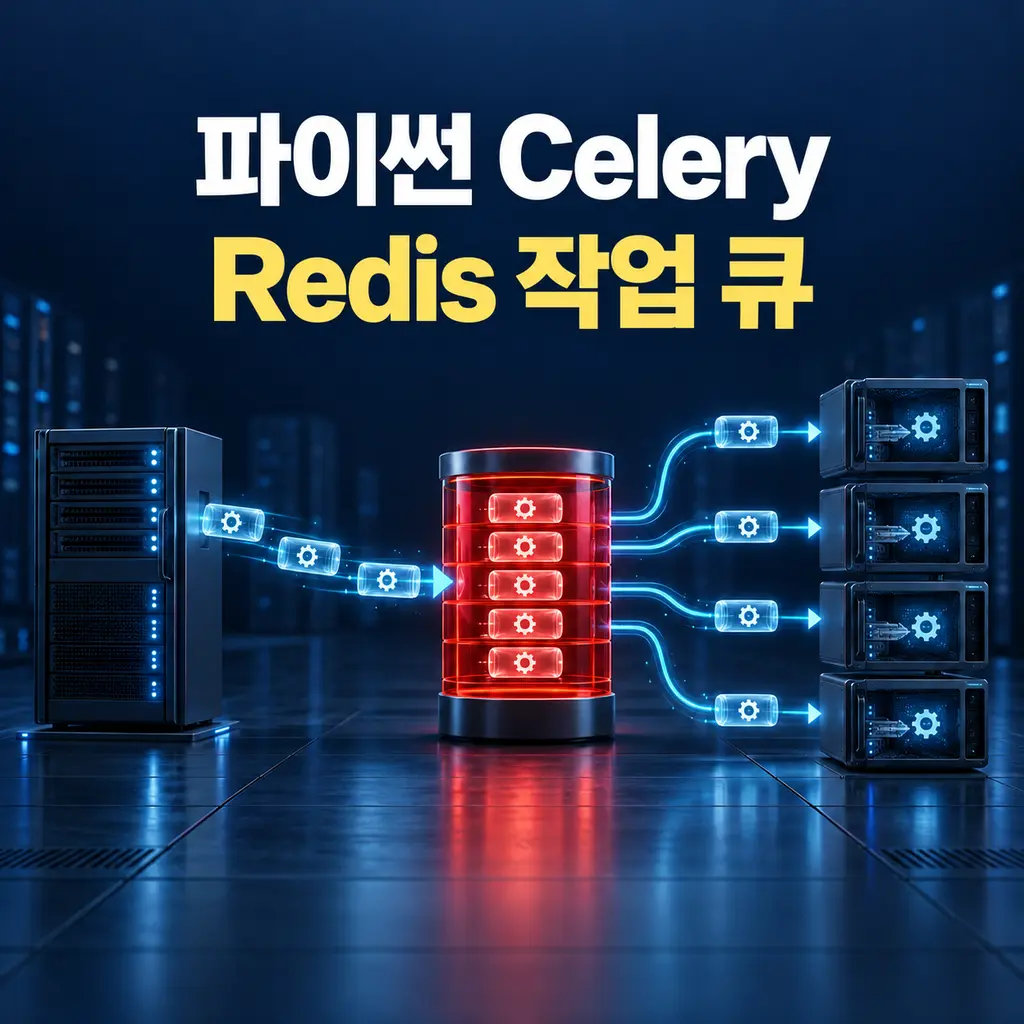
파이썬 웹 요청에서 오래 걸리는 이메일 발송·파일 변환·데이터 집계를 분리하려면 Celery 작업을 Redis 브로커에 넣고 별도 워커가 실행하도록 구성하면 됩니다. 핵심은 “비동기 호출” 자체보다 재시도해도 안전한 작업 설계, 타임아웃, 중복 실행 방지, 모니터링까지 함께 준비하는 것입니다.
핵심 요약
- 프로듀서는 메시지를 브로커에 보내고 워커는 큐에서 가져와 실행합니다.
- Redis는 브로커와 결과 백엔드로 각각 쓸 수 있지만 두 역할은 구분해야 합니다.
delay()는 간단한 호출,apply_async()는 예약·재시도·큐 지정 같은 제어에 적합합니다.- 작업은 중복 실행돼도 결과가 망가지지 않도록 멱등성을 갖춰야 합니다.
Celery와 Redis가 맡는 역할
Celery는 작업을 보내고 실행 상태를 관리하는 분산 태스크 큐입니다. 웹 애플리케이션 같은 프로듀서가 작업 메시지를 브로커에 넣으면, 별도 프로세스인 워커가 메시지를 받아 함수를 실행합니다. 사용자는 긴 작업이 끝날 때까지 HTTP 응답을 붙잡고 기다리지 않아도 됩니다.
| 구성요소 | 역할 | 주의점 |
|---|---|---|
| 프로듀서 | 태스크를 큐에 보냄 | 민감정보를 인자로 보내지 않기 |
| Redis 브로커 | 대기 메시지 전달 | 인증·네트워크 격리·메모리 정책 |
| Celery 워커 | 태스크 실제 실행 | 동시성·타임아웃·정상 종료 |
| 결과 백엔드 | 상태와 반환값 보관 | 불필요하면 결과 저장 생략 |
브로커와 결과 백엔드는 같은 Redis 인스턴스나 서로 다른 저장소를 사용할 수 있습니다. 결과가 필요 없는 이메일 알림 같은 작업은 ignore_result를 고려할 수 있고, 상태 조회가 필요하면 보존 기간과 삭제 정책을 정해야 합니다.
설치와 최소 설정
공식 문서 기준으로 Redis 지원 의존성까지 설치하려면 pip install -U "celery[redis]"를 사용합니다. Redis 연결 문자열은 보통 redis://호스트:6379/0 형식입니다. 비밀번호가 들어간 URL을 코드에 직접 쓰지 말고 환경변수에서 읽으세요.
import os
from celery import Celery

redis_url = os.environ.get("CELERY_REDIS_URL", "redis://localhost:6379/0")
app = Celery("worker", broker=redis_url, backend=redis_url)
app.conf.update(
    task_serializer="json",
    accept_content=["json"],
    result_serializer="json",
    timezone="Asia/Seoul",
    enable_utc=True,
    result_expires=3600,
)
예제의 로컬 기본값은 개발용입니다. 운영 환경에서는 Redis를 인터넷에 그대로 노출하지 말고 접근 제어, TLS 지원 방식, 비밀번호 또는 클라우드 인증, 백업·장애 복구 정책을 확인해야 합니다. 브로커 데이터베이스 번호만 나누는 것은 강한 보안 격리가 아닙니다.
태스크 작성과 워커 실행
from celery import Celery

app = Celery("tasks")

@app.task(bind=True, autoretry_for=(TimeoutError,),
          retry_backoff=True, retry_kwargs={"max_retries": 3})
def make_report(self, report_id: int):
    return {"report_id": report_id, "status": "done"}
워커는 모듈 위치에 맞춰 celery -A tasks worker --loglevel=INFO처럼 실행합니다. 호출 측의 make_report.delay(42)는 즉시 AsyncResult를 반환하고 실제 계산은 워커가 수행합니다. 실행 시각, 큐, 만료시간을 세밀하게 지정하려면 apply_async()를 사용합니다.
job = make_report.apply_async(
    args=[42],
    queue="reports",
    countdown=10,
    expires=300,
)
웹 요청 안에서 곧바로 job.get()으로 결과를 기다리면 비동기 처리의 장점이 줄어듭니다. 작업 ID를 반환하고 별도 상태 API나 알림으로 완료를 확인하는 구조가 일반적입니다.
재시도와 중복 실행을 안전하게 설계하기
분산 큐에서는 워커 장애, 연결 끊김, 확인 응답 지연 때문에 같은 메시지가 다시 전달될 수 있습니다. 따라서 “정확히 한 번 실행될 것”이라고 가정하지 말고 같은 요청이 반복돼도 결과가 한 번 처리된 것과 같도록 멱등성을 설계하세요.
- 업무 고유키나 요청 ID를 데이터베이스에 유일값으로 저장합니다.
- 처리 시작 전 이미 완료된 요청인지 확인합니다.
- 외부 결제·메일 API가 지원하면 idempotency key를 사용합니다.
- 데이터 변경과 처리 상태 기록을 가능한 한 하나의 트랜잭션으로 묶습니다.
- 재시도 가능한 일시 오류와 재시도해도 해결되지 않는 입력 오류를 구분합니다.
지수 백오프와 최대 재시도 횟수를 두고, 모든 예외를 무조건 재시도하지 마세요. 긴 작업은 soft time limit과 hard time limit을 업무 특성에 맞게 정하고, 중간 결과를 안전하게 정리할 수 있도록 만드세요. Redis transport의 visibility timeout보다 실행 또는 ETA 대기가 길면 재전달이 생길 수 있으므로 공식 주의사항을 확인해야 합니다.
운영 환경에서 확인할 항목
워커 수는 CPU 작업과 I/O 작업을 분리해 결정합니다. 이미지 인코딩처럼 CPU를 많이 쓰는 큐와 외부 API 호출 큐를 나누면 한 종류의 작업이 전체를 막는 상황을 줄일 수 있습니다. 우선순위가 중요한 작업도 별도 큐와 워커로 분리하세요.
모니터링에서는 큐 길이, 작업 대기시간, 성공·실패·재시도 수, 실행시간, 워커 가용성, Redis 메모리를 봅니다. 결과 백엔드를 사용하면 모든 AsyncResult를 무기한 보관하지 말고 가져오거나 forget() 처리 및 만료 정책을 적용해야 합니다.
배포 전 장애 시나리오를 시험하세요
정상 실행만 확인하지 말고 태스크 처리 중 워커를 종료하거나 Redis 연결을 잠시 끊어 보세요. 다시 시작했을 때 미확인 메시지가 어떻게 재전달되는지, 같은 작업이 반복돼도 데이터가 중복 저장되지 않는지 확인해야 합니다. 외부 API가 느리거나 429·5xx 오류를 반환할 때 연결 타임아웃과 재시도 간격도 시험하세요.
워커 배포 시에는 새 프로세스가 준비된 뒤 기존 프로세스를 정상 종료하는 순서를 지키는 것이 좋습니다. 작업 코드와 메시지 형식이 바뀌면 구버전 워커가 신버전 메시지를 가져갈 수 있으므로 단계적 배포의 호환성을 확인하고, 호환되지 않는 변경은 큐 이름이나 태스크 버전을 분리하세요. 작업 인자에는 거대한 파일 내용을 넣지 말고 파일 위치나 레코드 ID처럼 작은 참조값을 전달하는 편이 안정적입니다.
실수 방지 체크리스트
- Redis 주소와 인증정보를 환경변수로 분리합니다.
- 태스크 인자는 JSON으로 직렬화 가능한 최소 데이터만 보냅니다.
- 비밀번호·토큰·개인정보를 큐 메시지와 로그에 남기지 않습니다.
- 작업에 멱등성 키와 중복 완료 검사를 둡니다.
- 재시도 대상 예외, 백오프, 최대 횟수를 명시합니다.
- 장시간 작업의 타임아웃과 visibility timeout 관계를 점검합니다.
- 결과가 필요 없는 작업은 저장을 생략하고 필요한 결과에는 만료를 둡니다.
- 큐별 워커 분리와 동시성 제한을 부하 테스트합니다.
- 강제 종료 후 미확인 작업이 재처리되는지 시험합니다.
- Redis 장애와 워커 무응답 알림을 설정합니다.
자주 묻는 질문
1. Celery만 설치하면 동작하나요?
메시지를 주고받을 브로커가 필요합니다. Redis를 쓴다면 Redis 서버와 관련 의존성을 준비해야 합니다.
2. Redis는 브로커와 결과 백엔드를 동시에 할 수 있나요?
가능하지만 역할과 데이터 보존 정책은 별도로 설계해야 하며 부하와 장애 범위도 검토해야 합니다.
3. delay와 apply_async의 차이는 무엇인가요?
delay()는 간단한 바로 실행용 단축 호출이고, apply_async()는 큐·예약·만료 등 옵션을 지정할 수 있습니다.
4. 태스크 결과가 계속 PENDING인 이유는 무엇인가요?
결과 백엔드 미설정, 결과 무시 설정, 서로 다른 백엔드를 보는 구형 워커 등을 확인해야 합니다. PENDING은 알려지지 않은 작업에도 표시될 수 있습니다.
5. 작업이 두 번 실행될 수 있나요?
네. 확인 응답과 장애 상황에서 재전달될 수 있으므로 멱등하게 작성해야 합니다.
6. Redis DB 번호를 나누면 완전히 격리되나요?
키 공간 구분에는 도움이 되지만 동일 서버 자원과 보안 경계를 공유하므로 완전한 격리로 보기는 어렵습니다.
7. 먼 미래 작업도 countdown으로 예약하면 되나요?
공식 문서는 긴 ETA가 visibility timeout과 충돌할 수 있음을 경고합니다. 먼 일정은 데이터베이스 기반 스케줄러를 검토하세요.
8. 워커 수는 많을수록 좋은가요?
아닙니다. CPU·메모리·외부 API 제한에 맞춰 부하 테스트로 정해야 합니다.
9. 결과 백엔드는 반드시 필요한가요?
반환값이나 상태 조회가 필요 없다면 생략할 수 있습니다. 필요할 때만 보존 기간과 자원 회수 방식을 정하세요.
10. Celery가 asyncio를 대체하나요?
아닙니다. asyncio는 한 프로세스의 비동기 I/O에, Celery는 프로세스·서버를 넘어 작업을 큐로 분리하는 데 주로 사용됩니다.
공식 출처와 확인일
- Celery 공식 First Steps — 브로커, 워커, 호출, 결과 백엔드 확인
- Celery 공식 Using Redis — 설치, URL 형식, visibility timeout, 결과 설정 확인
실제 확인일: 2026년 9월 9일. 운영 설정은 현재 사용 중인 Celery·Redis 버전과 인프라 조건에 맞춰 공식 문서를 반드시 다시 확인하세요.